3. Objectif stratégique 3 : atténuer, s’adapter et gérer les effets de la sécheresse afin de renforcer la résilience des populations et des écosystèmes vulnérables
3.1. OS 3-1 – Évolution de la proportion de terres touchées par la sécheresse par rapport à la superficie totale des terres
3.1.1. Introduction
La Convention des Nations unies sur la lutte contre la désertification (CNULCD) définit la sécheresse comme un phénomène naturel qui se produit lorsque les précipitations sont nettement inférieures aux niveaux normaux enregistrés, provoquant de graves déséquilibres hydrologiques qui ont des effets néfastes sur les systèmes de production des ressources terrestres[1].
L’indicateur OS 3-1 décrit spécifiquement l’état (c’est-à-dire l’occurrence ou l’absence de sécheresse et sa gravité, le cas échéant) des risques de sécheresse météorologique sur une base annuelle dans un pays.
Il existe plusieurs indices de sécheresse qui peuvent être utilisés pour estimer le risque de sécheresse au niveau national. La méthodologie de la CNULCD pour estimer l’indicateur OS 3-1 recommande d’utiliser un indice de sécheresse spécifique accepté au niveau mondial, connu sous le nom d’indice de précipitations normalisé (SPI), pour caractériser le risque de sécheresse météorologique. Toutefois, les Parties peuvent utiliser d’autres indices s’ils sont déjà utilisés au niveau national, par exemple l’indice standardisé d’évapotranspiration des précipitations (SPEI). Pour les autres indices actuellement utilisés, les Parties peuvent avoir besoin de s’assurer de la cohérence statistique avec les classes d’intensité de la sécheresse de SPI décrites dans le tableau 19[2].
L’objectif général est de permettre aux Parties d’évaluer les risques de sécheresse et d’identifier les zones touchées par la sécheresse afin de hiérarchiser les efforts d’atténuation, en lien avec les évaluations de l’exposition à la sécheresse (OS 3-2) et de la vulnérabilité (OS 3-3). La communication des informations au niveau national est facilitée par la mise à disposition de données par défaut.
3.1.2. Conditions préalables à la présentation de comptes rendus
Une lecture approfondie du chapitre 1 du Good Practice Guidance for National Reporting on UNCCD Strategic Objective 3: To mitigate, adapt to, and manage the effects of drought in order to enhance resilience of vulnerable populations and ecosystems qui détaille la méthodologie employée pour estimer les risques de sécheresse et les variations au fil du temps ;
Données conformes aux spécifications énumérées à la figure 5 et au tableau 18.
Un groupe d’experts nationaux officiellement désignés par les autorités nationales pour vérifier la cohérence des résultats du processus de déclaration avec la situation sur le terrain, ou pour élaborer et mettre en œuvre une méthodologie sur mesure permettant d’estimer l’indicateur OS 3-1 lorsque les données nationales sont préférables aux données par défaut. Parmi les institutions clés peuvent figurer le service météorologique et hydrologique national (SMHN) d’un pays, le ministère de l’Environnement, le ministère de l’Agriculture, le centre de télédétection et l’office national de statistique, ainsi que les universités et centres de recherche concernés.
3.1.3. Cycle de présentation des comptes rendus et procédure étape par étape
La procédure de compte rendu étape par étape est décrite ci-après. Si les Parties décident d’utiliser les données par défaut, les étapes 2 à 5 ne sont pas nécessaires.
Étape 1 : Sélection de l’indice de sécheresse ou de l’ensemble de données sur les précipitations
La CNULCD fournit des données par défaut issues du produit « Global Multi-Index Drought » (GMID), un ensemble maillé d’indices de sécheresse comprenant le SPI et le SPEI, calculés à partir de données pluviométriques issues d’une combinaison de relevés pluviométriques, d’observations satellitaires et de données de réanalyse. Voir l’encadré 5 ci-dessous pour un aperçu de ce produit.
Bien que le SPI reste l’indice recommandé pour estimer l’indicateur OS 3-1, les Parties devraient déterminer si le SPEI est plus adapté à leur situation spécifique, en particulier dans les zones arides et semi-arides où les précipitations sont irrégulières et les cumuls faibles. Le SPEI tenant compte à la fois des précipitations et de la température de l’air, il peut fournir une mesure plus précise de la disponibilité en eau dans ces zones, où les pertes par évapotranspiration peuvent être importantes. Une analyse plus détaillée des cas dans lesquels un indice peut être préférable à l’autre figure à la section 1.5 du document intitulé Guide des bonnes pratiques pour l’établissement des comptes rendus nationaux sur l’objectif stratégique 3 de la CNULCD.
Si les pays Parties disposent déjà d’un indice de sécheresse national tel que le SPI ou le SPEI, ils peuvent l’utiliser de préférence aux données par défaut de la CNULCD. Par ailleurs, s’ils souhaitent calculer eux-mêmes l’indice SPI, ils ont la possibilité d’utiliser un jeu de données alternatif fourni par Trends.Earth ou d’utiliser les données de précipitations du pays.
L’autre ensemble de données disponible via Trends.Earth est le Climate Hazards Group InfraRed Precipitation with Stations (CHIRPS), qui produit des estimations de précipitations à haute résolution basées sur des observations satellitaires et des données provenant de stations pluviométriques. Si la résolution spatiale légèrement supérieure de CHIRPS est un avantage pour le calcul du SPI, l’inconvénient est qu’il n’offre pas une couverture mondiale et ne s’étend que de 50° S à 50° N. Par conséquent, les Parties dont les frontières nationales se situent en dehors de cette plage ne pourront pas utiliser l’ensemble de données CHIRPS. En revanche, le GMID offre une couverture mondiale. Alors que le GMID comprend à la fois le SPI et le SPEI, seul le SPI sera disponible pour CHIRPS sur Trends.Earth.
L’arbre de décision présenté à la figure 5 peut aider les Parties à déterminer quel ensemble de données et quelle approche sont les plus adaptés pour étayer leurs comptes rendus sur leur situation nationale.
Figure 5. Arbre de décision destiné à aider les Parties à choisir la meilleure source de données sur les indices de précipitations ou de sécheresse pour calculer l’indicateur OS 3-1
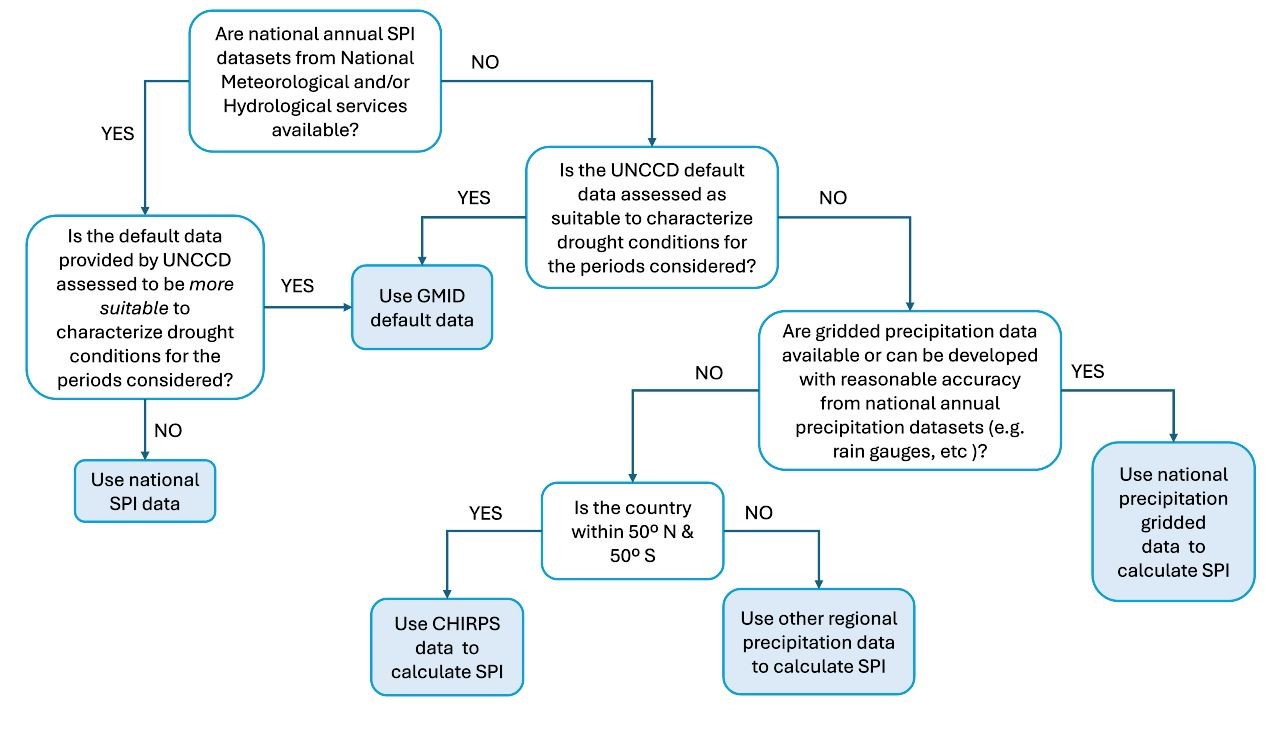
GMID: Global Multi-Index Drought,
SPI : Standardized Precipitation Index,
CHIRPS: Climate Hazards Group InfraRed Precipitation with Stations
Ce processus de prise de décision devrait aider les Parties à identifier les données qui répondent aux spécifications résumées dans le tableau 18.
Élément |
Spécifications |
|
|---|---|---|
Données par défaut |
Données nationales |
|
Données entrantes Données nécessaires pour produire des estimations de l’aléa sécheresse basées sur les calculs de l’indice standardisé des précipitations (SPI) décrits à l’étape 2 |
Produits mensuels de l’indice de sécheresse Global Multi-Index Drought (GMID), 1980-2023. |
Produits maillés des précipitations totales mensuelles dérivées des réseaux nationaux de jaugeage. Afin de calculer la période de référence alignée sur l’OMM, le jeu de données devrait idéalement avoir un enregistrement continu d’au moins 30 ans, couvrant la période 1981-2010. Pour les pays situés entre 50°S et 50°N : les produits mensuels de précipitations du Climate Hazards Group InfraRed Precipitation with Stations (CHIRPS), 1981-présent, sont accessibles dans Trends.Earth*. Des périodes d’accumulation alternatives à SPI-12 sont également possibles dans Trends.Earth lorsque vous utilisez CHIRPS, par exemple SPI-9, SPI-24 et SPI-48. |
Données sortantes Produits maillés intermédiaires et finaux résultant de l’analyse décrite aux étapes 2 à 4 |
Grilles SPI-12 de décembre classées en quatre classes d’intensité de sécheresse SPI sur une base annuelle*. Superficie totale des terres pour chaque catégorie d’intensité de sécheresse ainsi que proportion de la superficie totale frappée par la sécheresse. Résumé spatial en grille par périodes de quatre ans. |
Grilles SPI-12 annuelles de décembre classées en quatre classes d’intensité de sécheresse SPI sur une base annuelle*. Superficie totale des terres pour chaque catégorie d’intensité de sécheresse ainsi que proportion de la superficie totale frappée par la sécheresse. Résumé spatial en grille par périodes de quatre ans. |
Classification |
Quatre catégories d’intensité de sécheresse de SPI conformément au tableau 19. |
Quatre catégories d’intensité de sécheresse de SPI conformément au tableau 19. |
Résolution spatiale |
GMID : 0,1° x 0,1° (~11,1 km) |
CHIRPS : 0,05° x 0,05° (~5,55 km) ou autrement évaluée par les autorités nationales en fonction des données disponibles. |
Qualité |
Précisée dans les métadonnées des ensembles de données. |
Les données doivent être continues dans la mesure du possible ; lorsque l’exhaustivité des données est inférieure à 85 %, les Parties peuvent envisager de combler les lacunes en matière de données conformément aux orientations de l’Organisation météorologique mondiale (OMM, 2018). |
Métadonnées |
Des métadonnées sont fournies avec les données par défaut. |
Les métadonnées minimales exigées pour chaque champ obligatoire sont énumérées à l’annexe II. |
* Comme indiqué à l’étape 3, les valeurs de décembre de SPI sur 12 mois représentent les déficits (ou les excédents) de précipitations sur une année du calendrier grégorien (janvier-décembre).
Encadré 5. L’ensemble de données du Global Multi-Index Drought (GMID)
Ce jeu de données comprend l’indice standardisé des précipitations (SPI) et l’indice standardisé d’évapotranspiration des précipitations (SPEI) sur des échelles temporelles de 1 à 12 mois à haute résolution spatiale, couvrant la période 1980-2023 à l’échelle mondiale. Le jeu de données offre une couverture spatiale à travers les longitudes mondiales de -180° à 180° et les latitudes de 90° à -90°. Les données sont fournies en coordonnées géographiques (latitude/longitude) basées sur le système de référence WGS 84 (World Geodetic System 1984), à une résolution de 0,1°.
Les indices SPI et SPEI ont été calculés à partir de la distribution de probabilité la plus couramment utilisée et recommandée pour leur calcul à différentes échelles de temps. Ainsi, le SPI a été calculé à l’aide d’une distribution gamma, tandis que le SPEI a été calculé à l’aide d’une distribution log-logistique. L’ensemble de données a été généré à partir de différentes sources de données météorologiques, notamment : les données de précipitations issues du modèle MSWEP (Multi-Source Weighted-Ensemble Precipitation) v2.8 (https://www.gloh2o.org/mswep/), et des données d’évapotranspiration potentielle issues du modèle GLEAM (Global Land Evaporation Amsterdam Model) v4.2a (https://www.gleam.eu). Les données ont été téléchargées à une fréquence quotidienne, puis agrégées mensuellement, et enfin synthétisées sur différentes périodes d’accumulation afin d’obtenir les indices sur des échelles de temps de 1, 2, 3, 4, 5, 6, 7, 8, 9, 10, 11 et 12 mois.
L’ensemble des données du GMID est disponible à l’adresse suivante : https://eidc.ac.uk/
Étape 2 : Calculer l’indice de précipitations normalisé
Les séries temporelles mensuelles de l’indice SPI sont basées sur les données de précipitations maillées sélectionnées et calculées à l’aide de la méthode SPI-12, qui fournit un résumé annuel des déficits de précipitations pour chaque mois à l’aide d’une méthode d’accumulation sur 12 mois. Par exemple, l’accumulation des précipitations sur 12 mois pour décembre 2019 est le total des précipitations mensuelles de janvier 2019 à décembre 2019.
Il est important de veiller à ce que, pour chaque année de référence, les données pluviométriques soient normalisées par rapport à une même « période de référence » ou période climatologique standard. Cela garantit la comparabilité des données d’une année à l’autre, ainsi que dans le temps et dans l’espace. Afin de normaliser les distributions des données d’accumulation pluviométrique sur 12 mois, la période climatologique standard de l’OMM, couvrant les années 1981 à 2010, est utilisée comme période de référence. La méthode de normalisation repose sur une fonction de distribution de probabilité gamma ajustée aux cumuls de précipitations sur 12 mois observés au cours de cette période de référence. Une fois calculés, ces paramètres de distribution de probabilité sont ensuite appliqués à toute série chronologique de cumuls mensuels de précipitations sur 12 mois afin de produire la série chronologique mensuelle normalisée du SPI-12 pour chaque maille de la grille, sur l’ensemble de la période pour laquelle des données sont disponibles. Toutefois, si les Parties choisissent de modifier la période climatologique normale (de référence), cela nécessite alors un nouveau calcul du SPI pour toutes les périodes. À ce titre, il est recommandé que la période de référence utilisée pour calculer le SPI soit clairement indiquée dans les comptes rendus nationaux relatifs à l’indicateur OS 3-1 adressés à la CNULCD.
Les données SPI et SPEI par défaut sont disponibles dans Trends.Earth aux fins de la surveillance de l’OS3. Cependant, il existe plusieurs outils en libre accès qui peuvent être utilisés pour calculer l’indice SPI, dont une sélection est répertoriée dans le tableau 3 du Guide des bonnes pratiques pour les comptes rendus nationaux sur l’objectif stratégique 3 de la CNULCD.
Étape 3 : identifier la catégorie d’intensité de sécheresse de chaque maille d’après la valeur calculée de SPI
Note
Domaines connexes sur la plateforme du système PRAIS 4 : tableau OS3-1.T1
Pour analyser la série chronologique du SPI sur une base annuelle, il convient d’extraire les valeurs du SPI-12 de décembre pour chaque année. Les valeurs du SPI-12 de décembre représentent les déficits (ou excédents) pluviométriques sur l’année civile grégorienne (janvier-décembre).
Pour chacune des grilles SPI-12 de décembre, il convient de compter le nombre de cellules appartenant à chacune des classes d’intensité de la sécheresse SPI énumérées dans le tableau 19. Notez que toute cellule avec une valeur > 0 représente une zone sans sécheresse.
Valeurs SPI |
Catégorie d’intensité de sécheresse |
|---|---|
0 à -0,99 |
Légère sécheresse |
-1,0 à -1,49 |
Sécheresse modérée |
-1,5 à -1,99 |
Grande sécheresse |
-2 et inférieur |
Sécheresse extrême |
La superficie totale relevant de chaque catégorie d’intensité de sécheresse doit être calculée en deux temps :
Projetez la grille des classes d’intensité de sécheresse dans une projection équiariale appropriée (par exemple, Mollweide) afin d’obtenir la superficie des cellules en km2.
Additionnez les superficies de toutes les cellules d’une classe de sécheresse donnée afin d’obtenir la superficie totale correspondant à chaque classe d’intensité de sécheresse.
Étape 4 : Calculer la proportion de terres touchées par la sécheresse sans ventilation par classe
Note
Domaines connexes sur la plateforme du système PRAIS 4 : tableau OS3-1.T2
La proportion de terres touchées par la sécheresse, quelle que soit la classe d’intensité, est calculée pour chaque année de référence en pourcentage de la superficie totale des terres.
Pour chacune des grilles annuelles de l’indice SPI-12, le nombre total de cellules appartenant à l’une des classes d’intensité de la sécheresse de l’indice SPI est compté (cellCount). Ensuite, pour chaque année de déclaration, le pourcentage de la superficie totale des terres touchées par la sécheresse est calculé. La formule est la suivante :
\(P_{j} = \frac{cellCount_{j}}{\text{Total number of cells}} \times 100\)
Où :
« Pj » correspond à la proportion de terres touchées par la sécheresse au cours de l’année de référence (j)
« cellCountj » correspond au nombre total de pixels touchés par la sécheresse au cours de l’année de référence (j)
« Total number of cells » correspond à l’ensemble des cellules de la grille situées sur le territoire du pays concerné.
La superficie totale touchée par la sécheresse chaque année est calculée en multipliant le nombre de cellules par la superficie de chacune d’entre elles (une valeur constante, puisque la grille des classes d’intensité de sécheresse a été préalablement convertie en une projection à aire égale).
Étape 5 : Créer des cartes d’intensité de la sécheresse pour des périodes de quatre ans
Outre les comptes rendus sous forme de tableaux décrits ci-dessus, l’indicateur OS 3-1 devrait également faire l’objet d’une synthèse spatiale afin de cartographier les conditions de sécheresse les plus intenses survenues au cours de périodes de quatre ans. Le choix de périodes de quatre ans vise à alléger la charge administrative liée à la communication d’informations et à réduire le volume de données qui serait associé à la communication annuelle d’informations spatiales.
Pour résumer ces périodes sur le plan spatial, il convient, pour chaque cellule de la grille, d’identifier la classe d’intensité de sécheresse la plus élevée dans cette cellule au cours de chacune des périodes de quatre ans. Par exemple, si une cellule de la grille présente les valeurs (légère, légère, modérée, légère) pour une période de quatre ans donnée, alors cette cellule doit contenir la valeur « modérée » pour cette période de quatre ans.
L’intensité de la sécheresse la plus élevée pour les périodes de quatre ans devrait être cartographiée à l’aide des données SPI-12 maillées par intervalles de quatre ans (2000-2003, 2004-2007, 2008-2011, 2012-2015, 2016-2019 et 2020-2023). Si les pays Parties ont des lacunes (c’est-à-dire des années manquantes) dans leurs ensembles de données, ils doivent les résumer sur les périodes les plus appropriées afin de les aligner le plus possible sur les périodes quadriennales susmentionnées. Par exemple, si une partie de l’ensemble de données est représentée par 2004, 2007, 2008, 2009, 2011, les périodes de synthèse les plus appropriées seraient (2004, 2007) et (2008, 2009, 2011).
Étape 6 : Vérifier les résultats
Les Parties doivent être conscientes des limites liées à l’utilisation du SPI en tant qu’indicateur unique de sécheresse et examiner d’un œil critique les données par défaut par rapport aux données des pluviomètres nationaux et à d’autres sources météorologiques avant de soumettre leurs comptes rendus nationaux.
Étape 7 : Enregistrer le formulaire et le mettre à disposition pour examen
Les changements observés et leur interprétation peuvent être décrits dans les champs de commentaires associés aux tableaux de compte rendu de la plateforme PRAIS 4.
Les cartes d’intensité de la sécheresse par défaut ou les cartes générées dans Trends.Earth à l’aide de données nationales représentant les conditions de sécheresse les plus intenses pour des périodes de quatre ans sont mises à disposition dans la plateforme PRAIS 4. Plus précisément, les cartes suivantes seront disponibles :
Conditions de sécheresse les plus intenses en 2000-2003
Conditions de sécheresse les plus intenses en 2004-2007
Conditions de sécheresse les plus intenses en 2008-2011
Conditions de sécheresse les plus intenses en 2012-2015
Conditions de sécheresse les plus intenses en 2016-2019
Conditions de sécheresse les plus intenses en 2020-2023
Les Parties doivent noter que les cartes par défaut illustrant l’intensité de la sécheresse sur une période de quatre ans reposent sur les mêmes données par défaut que celles communiquées dans le document OS3-1.T1. Toutefois, comme expliqué à l’étape 5, si une Partie communique des données nationales et qu’il manque certaines années, les cartes récapitulatives peuvent être établies à partir des données disponibles qui correspondent le mieux aux périodes de quatre ans susmentionnées. Les Parties sont également invitées à fournir, dans le champ « Commentaires généraux », des explications sur la méthodologie, les sources de données et la précision des données lorsque les estimations sont établies à partir de données nationales. Il serait également utile de signaler les cas particuliers et les problèmes rencontrés, en décrivant les situations dans lesquelles les valeurs SPI pourraient s’avérer moins fiables et justifier le recours à une autre méthodologie.
Une fois le formulaire rempli et vérifié par les Parties, il doit être marqué comme « En cours d’examen » puis enregistré. Une fois que la CNULCD a achevé son examen et que les Parties ont donné suite à toutes les observations formulées, le formulaire peut être marqué comme « Finalisé » puis enregistré.
3.1.4. Dépendances
Les données sur les risques de sécheresse s’appuient sur la superficie totale des terres indiquée dans le tableau CP-1.T1 pour calculer la proportion de la superficie totale des terres soumise à la sécheresse. Les résultats de l’indicateur OS 3-1 sont également utilisés pour calculer l’indicateur OS 3-2.
3.1.5. Difficultés
Disponibilité et qualité des données
Les données sur les précipitations disponibles au niveau international pourraient ne pas être suffisamment précises pour estimer l’intensité du risque de sécheresse au niveau national. Il est recommandé d’utiliser les données nationales, car l’on part du principe qu’elles sont plus précises et plus fiables. Cependant, il se pourrait que les données nationales sur les précipitations ne soient pas facilement disponibles au format numérique et/ou que les séries chronologiques ne soient pas complètes.
Limites des estimations fondées sur le SPI
Bien que le SPI soit recommandé comme un indice de sécheresse bien établi, flexible et robuste pour quantifier le risque de sécheresse à l’échelle mondiale, il ne quantifie que les déficits météorologiques, puisqu’il repose exclusivement sur les précipitations, et d’autres types de sécheresse (par exemple, hydrologique, agricole) peuvent ne pas être correctement pris en compte. De plus, dans les régions où la proportion de mois sans précipitations est très faible et/ou élevée, les valeurs du SPI doivent être utilisées et interprétées avec prudence ; l’utilisation du SPEI pourrait s’avérer plus appropriée dans ces régions. Conscient de cette limite, l’expert national peut mettre en évidence les zones où les estimations basées sur le SPI risquent de ne pas produire des résultats suffisamment précis et peut fonder ses estimations sur d’autres indices. Une analyse des limites du SPI figure à la section 1.5 du document « Guide des bonnes pratiques pour les comptes rendus nationaux sur l’objectif stratégique n° 3 de la CNULCD »
Les zones hyperarides sont incluses dans les données SPI fournies par défaut. Toutefois, les valeurs de l’indice relatives à ces zones doivent être interprétées avec prudence, compte tenu des limites du calcul de l’indice de sécheresse dans ces régions. Ces limites peuvent entraîner une surestimation ou une sous-estimation des épisodes de sécheresse dans les zones hyperarides.
En raison de la variabilité climatique naturelle, tout changement ou toute tendance observés concernant la proportion de terres touchées par la sécheresse au cours des périodes considérées doit être interprété avec prudence. Les anomalies et les incertitudes liées aux estimations doivent être décrites dans le champ « Commentaires relatifs au tableau ci-dessus ».
L’échelle de temps adoptée et mise à disposition par les données par défaut du GMID, basée sur un cycle de 12 mois, pourrait ne pas toujours convenir à la caractérisation des impacts de la sécheresse dans certains environnements. Si les Parties utilisent leurs propres données, elles devraient déterminer si d’autres périodes d’agrégation, par exemple 24 mois, pourraient être plus appropriées.
3.1.6. Résumé (principales étapes)
Les principales étapes à suivre pour présenter des comptes rendus sur les valeurs d’intensité du risque de sécheresse sont les suivantes :
Sélectionner l’indice de sécheresse ou le jeu de données sur les précipitations : les Parties peuvent décider d’utiliser les données d’indice de sécheresse par défaut ou d’autres sources nationales, à condition qu’elles soient conformes aux spécifications des données énumérées dans le tableau 18. Si les Parties décident d’utiliser une autre source de données sur les précipitations, elles doivent suivre les actions 2 à 5 ci-dessous :
Calculer l’indice SPI : l’indice SPI doit être calculé pour tous les mois de la série chronologique complète disponible ; toutefois, les Parties peuvent opter pour d’autres indices (par exemple, le SPEI) mieux adaptés à leurs conditions environnementales locales.
Déterminer la classe d’intensité de sécheresse de chaque cellule de la grille : sur la base du calcul du SPI (ou d’un autre indice de sécheresse), il convient de recenser le nombre de cellules appartenant à chacune des classes d’intensité de sécheresse et de convertir ces chiffres en superficies en projetant les grilles des classes d’intensité de sécheresse dans une projection équivalente appropriée, puis en calculant la superficie totale correspondant à chaque classe d’intensité de sécheresse en km2. Les données sont ensuite présentées dans le tableau OS3-1.T1.
Calculer la proportion de terres touchées par la sécheresse : la proportion de terres relevant de chaque classe d’intensité de sécheresse, ainsi que la proportion globale de terres soumises à des conditions de sécheresse, quelle qu’en soit l’intensité, par rapport à la superficie totale des terres, sont calculées pour chaque année de référence et présentées dans les tableaux OS3-1.T1 et OS3-1.T2.
Créer un ensemble de cartes de l’intensité de la sécheresse : les données pour l’ensemble de la série chronologique de 2000 à 2023 devraient être résumées spatialement en utilisant les données SPI-12 maillées, de préférence par intervalles de quatre ans (2000-2003, 2004-2007, 2008-2011, 2012-2015, 2016-2019 et 2020-2023) pour cartographier les conditions de sécheresse les plus intenses au cours de chaque période.
Vérifier les résultats : conscientes des limites liées à l’utilisation de l’indice SPI ou d’autres indices de sécheresse pour estimer l’intensité de la sécheresse, les Parties devraient vérifier la pertinence d’un tel indice pour décrire la survenue et l’intensité de la sécheresse dans leur pays avant de soumettre officiellement leurs estimations dans le cadre des comptes rendus au titre de la CNULCD.
Enregistrer le formulaire et le rendre disponible pour examen : une fois vérifiées par les Parties, les données et la note explicative doivent être marquées comme « En cours d’examen » et enregistrées, afin de les rendre disponibles pour examen par la CNULCD.
3.1.7. Ressources supplémentaires
WMO, 2018, Guide to climatological practices, second edition. Geneva, Switzerland. (https://library.wmo.int/viewer/60113)
3.2. OS 3-2 – Évolution de la proportion de la population totale exposée à la sécheresse
3.2.1. Introduction
L’indicateur OS 3-2 définit l’exposition de la population au risque de sécheresse (identifié par l’indicateur OS 3-1) comme le nombre total de personnes exposées ainsi que le pourcentage de la population totale exposée. Cet indicateur peut être ventilé par sexe si les données sont disponibles.
La méthode de calcul s’appuie sur la répartition spatiale de la population ou du sous-groupe de population (c’est-à-dire les hommes, les femmes, etc.) pour établir son exposition à la sécheresse, en fonction du lieu et de l’étendue des catégories d’intensité de sécheresse, comme déterminé par l’indicateur de l’OS 3-1. Grâce à ces informations, on peut calculer et communiquer le pourcentage de la population totale relevant de chaque catégorie d’intensité de sécheresse, ainsi que le pourcentage de la population totale exposé à la sécheresse (c’est-à-dire à toutes les catégories d’intensité de sécheresse). Les comptes rendus nationaux sont facilités par la fourniture de données par défaut.
3.2.2. Conditions préalables à la présentation de comptes rendus
Une lecture approfondie du chapitre 2 du Good Practice Guidance for National Reporting on UNCCD Strategic Objective 3 : To mitigate, adapt to, and manage the effects of drought in order to enhance resilience of vulnerable populations and ecosystems, qui détaille la méthodologie employée pour estimer l’exposition à la sécheresse ;
Données conformes aux spécifications énumérées à la figure 6 et au tableau 20.
Un groupe d’experts nationaux officiellement désignés par les autorités nationales pour vérifier la cohérence des résultats du processus de déclaration par rapport à la situation sur le terrain, ou pour élaborer et mettre en œuvre une méthodologie sur mesure permettant d’estimer l’indicateur OS 3-2 lorsque les données nationales sont préférables aux données par défaut. L’institution clé dans ce cas est l’office national de statistique du pays concerné, mais les universités et les centres de recherche peuvent également apporter une contribution précieuse.
3.2.3. Cycle de présentation des comptes rendus et procédure étape par étape
La procédure de compte rendu étape par étape est décrite ci-après. Si les Parties décident d’utiliser les données par défaut, les étapes 2 à 4 ne sont pas nécessaires.
Étape 1 : sélectionner l’ensemble de données sur la population
Il existe plusieurs ensembles de données démographiques à résolution spatiale fine disponibles à l’échelle mondiale et l’un d’entre eux, WorldPop, est fourni par défaut aux pays Parties pour calculer l’indicateur OS3-2. Les estimations nationales de la population féminine, masculine et totale pour la période 2000-2023 sont automatiquement pré-remplies dans le tableau CP-1.T2 et sont également disponibles sous forme de cartes annuelles quadrillées de la population. Toutefois, les Parties doivent noter que l’ensemble de données WorldPop 2000-2020 utilisé comme source de données par défaut pour le compte rendu 2026 n’a pas été mis à jour et que, par conséquent, les trois dernières années (2021, 2022 et 2023) reproduisent les valeurs de 2020. Ces données peuvent être utilisées en l’absence de données démographiques nationales pour le calcul de l’indicateur OS3-2.
Toutefois, les Parties peuvent choisir d’utiliser d’autres ensembles de données mondiaux ou nationaux relatifs aux recensements annuels de la population ventilés par sexe. Dans ce cas, ces valeurs doivent être saisies dans le champ CP1.T2. Les données sous-jacentes doivent provenir d’un produit démographique maillé couvrant l’ensemble du territoire national. Si l’ensemble de données disponible est un produit vectoriel (représentant par exemple des zones administratives), il doit d’abord être converti en une grille régulière indiquant le nombre de personnes vivant dans chaque lieu (cellule de la grille). Idéalement, les données doivent correspondre à des recensements annuels de la population, tant pour le total que pour les groupes ventilés par sexe (hommes, femmes).
Les Parties souhaitant utiliser des ensembles de données démographiques nationaux ou régionaux peuvent se référer à l’arbre de décision de la figure 6 pour déterminer si ces données sont plus adaptées au calcul de l’indicateur OS 3-2 que les ensembles de données disponibles à l’échelle mondiale.
Figure 6. Arbre de décision destiné à aider les Parties à choisir la meilleure source de données démographiques pour calculer l’indicateur OS 3-2
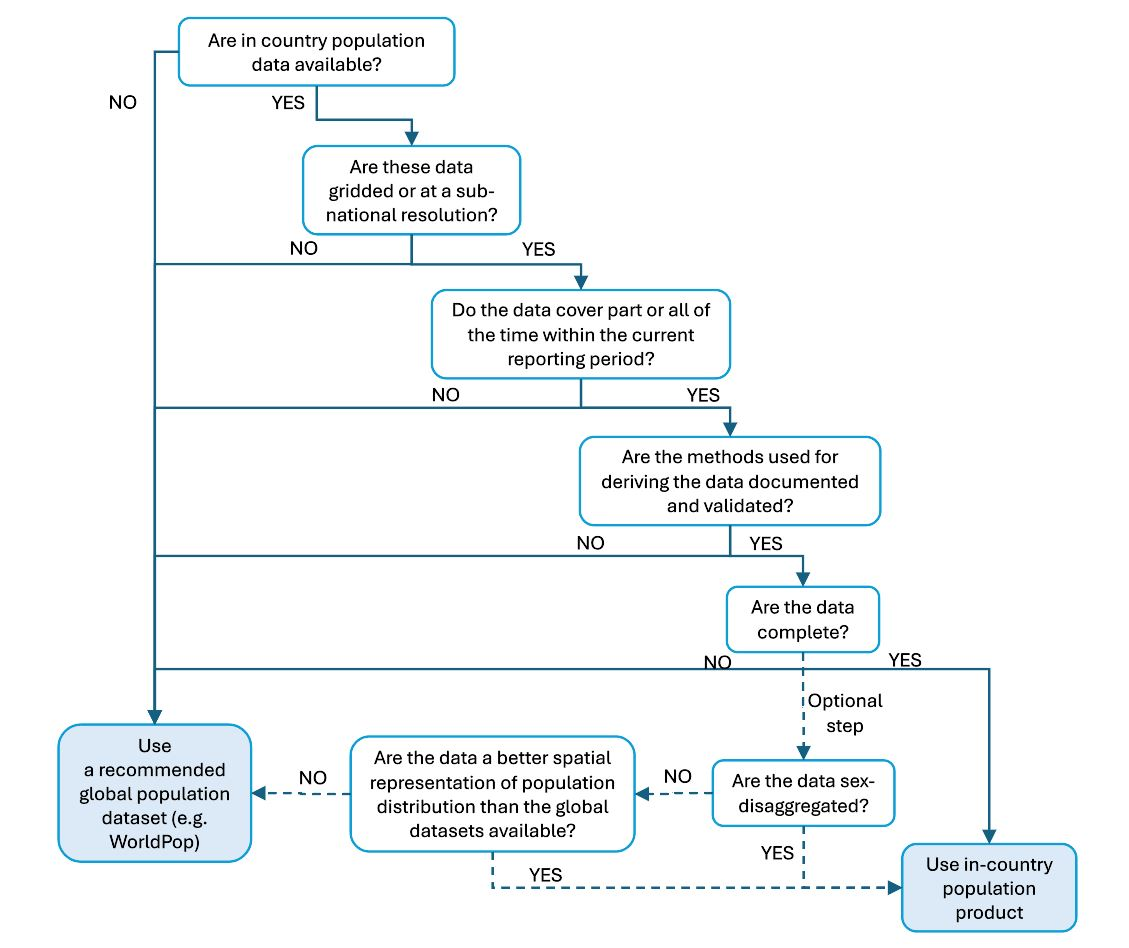
Ce processus de prise de décision devrait aider les Parties à identifier les données qui répondent aux spécifications résumées dans le tableau 20.
Élément |
Spécifications |
|
|---|---|---|
Données par défaut |
Données nationales |
|
Données entrantes Données nécessaires pour générer l’indicateur OS 3-2, comme décrit dans les étapes 2 à 4 |
Données WorldPop pour chaque année de la période 2020-2023, ventilées par sexe (les données de 2020 étant dupliquées pour 2021, 2022 et 2023 en raison de l’absence de données actualisées de WorldPop sur la population après 2020). Données relatives aux catégories d’intensité de sécheresse, comme déterminé par l’indicateur de l’OS 3-1. |
Produits maillés sur la population tirés des statistiques nationales officielles allant de l’année 2000 à l’année considérée, idéalement annuels et, si possible, ventilés par sexe. Données relatives aux catégories d’intensité de sécheresse, comme déterminé par l’indicateur de l’OS 3-1. |
Données sortantes Produits maillés résultant de l’analyse décrite aux étapes 2 à 4 |
Produits annuels maillés représentant (i) la population totale, (ii) la population féminine et (iii) la population masculine exposées aux quatre classes d’intensité de sécheresse, de l’année 2015 à l’année de référence. Pourcentage de la population totale, féminine et masculine exposée à la sécheresse et à chaque classe d’intensité de la sécheresse. Résumé spatial en grille par périodes de quatre ans. |
Produit annuel maillé représentant (i) la population totale, (ii) la population féminine et (iii) la population masculine exposées aux quatre classes d’intensité de sécheresse, de l’année 2000 à l’année de référence. Pourcentage de la population totale, féminine et masculine exposée à la sécheresse et à chaque classe d’intensité de la sécheresse. Résumé spatial en grille par périodes de quatre ans. |
Résolution spatiale |
Données WorldPop : 3 secondes d’arc (~0,00083º ou ~100 m) Données sur l’intensité du risque de sécheresse : 0,1° x 0,1° (~11,1 km) |
Évaluée par les autorités nationales en fonction des données disponibles. |
Métadonnées |
Des métadonnées sont fournies avec les données par défaut. |
Les métadonnées minimales exigées pour chaque champ obligatoire sont énumérées à l’annexe II. |
Étape 2 : Superposer les données démographiques maillées avec les données spatiales de l’indicateur OS 3-1
L’indicateur OS 3-2 est calculé en superposant les données démographiques aux données spatiales relatives à l’intensité du risque de sécheresse (OS 3-1) pour chaque année. Si l’on utilise des données autres que celles par défaut, les années manquantes doivent être complétées par les données démographiques disponibles les plus proches. Par exemple, si les données de 2019 font défaut, elles doivent être remplacées par celles de 2020 (ou de l’année disponible la plus proche) ; les données de 2020 seraient alors utilisées à la fois pour 2019 et pour 2020. Outre la population totale, les grilles de données démographiques ventilées par sexe, si elles sont disponibles, doivent être utilisées lors du processus de superposition afin de générer des valeurs d’exposition à la sécheresse ventilées par sexe.
Les données relatives à la population et à l’intensité des risques de sécheresse doivent avoir le même système de référence de coordonnées et la même projection géographique, qui doivent être cohérents entre les périodes de déclaration annuelles. En outre, les deux ensembles de données doivent avoir la même taille de grille. Pour ce faire, les données GMID de 0,1° x 0,1° (~11,1 km) doivent être rééchantillonnées sur une grille de 0,00083º (~100 m) (identique à WorldPop) en utilisant la technique de rééchantillonnage du plus proche voisin.
Étape 3 : Calculer la proportion de la population exposée dans chaque classe d’intensité de la sécheresse
Note
Domaines connexes sur la plateforme du système PRAIS 4 : tableaux OS3-2.T1, OS3-2.T2 et OS3-2.T3
En utilisant les résultats de l’étape 2, le nombre de personnes appartenant à chacune des quatre classes d’intensité de la sécheresse, ainsi que le nombre total de personnes exposées à la sécheresse (c’est-à-dire à toutes les classes d’intensité de la sécheresse), peuvent être estimés pour chaque année. Les pourcentages respectifs sont ensuite calculés à partir de la population totale, comme indiqué dans CP-1.T2. Ces valeurs annuelles en pourcentage sont ensuite reportées dans le tableau OS3-2.T1. Le nombre total de la population exposée est calculé automatiquement par PRAIS à l’aide de la valeur de la population totale indiquée dans CP-1.T2. Ce chiffre est ensuite automatiquement reporté dans le tableau OS3-2.T1.
De même, si des données ventilées par sexe sont utilisées, pour chaque année disponible, le nombre d’hommes et de femmes dans chaque classe d’intensité de la sécheresse, ainsi que le nombre total d’hommes et de femmes exposés à la sécheresse, peuvent également être calculés. Ces chiffres doivent ensuite être exprimés en pourcentage par rapport à la population nationale totale de ce sexe. Les valeurs en pourcentage pour la population féminine sont indiquées dans le tableau OS3-2.T2. Les valeurs en pourcentage pour les hommes sont indiquées dans le tableau OS3-2.T3.
Les Parties sont invitées à fournir des explications dans le champ « Commentaires » associé aux tableaux OS3-2.T1, OS3-2.T2 et OS3-2.T3 concernant la méthodologie, les sources de données et la précision des données, dans le cas où les estimations seraient issues de données mondiales ou nationales alternatives non par défaut.
Étape 4 : Créer des cartes d’exposition à la sécheresse par périodes de quatre ans
Outre les valeurs annuelles de l’indicateur OS 3-2 saisies dans les tableaux à l’étape 3, des cartes d’exposition à la sécheresse par période de quatre ans pour l’ensemble de la période doivent également être établies en externe et téléchargées dans PRAIS. Ces cartes d’exposition donnent une indication du nombre de personnes exposées à la classe de sécheresse d’intensité la plus élevée au cours de chaque période de quatre ans pour chaque cellule de la grille. Le choix de périodes de quatre ans vise à réduire la charge administrative liée à la déclaration et la quantité de données à télécharger dans PRAIS. Voir l’étape 5 concernant l’indicateur OS 3-1 pour plus de détails sur la préparation des cartes de sécheresse.
Étape 5 : Vérifier les résultats
Les Parties doivent être conscientes des limites liées à l’utilisation de l’indice SPI comme indicateur de sécheresse (voir OS3-1 ci-dessus) et examiner de manière critique les résultats avant de soumettre leurs comptes rendus à la CNULCD.
Étape 6 : Enregistrer le formulaire et le mettre à disposition pour examen
Les modifications observées et leur interprétation peuvent être décrites dans les champs de commentaires associés à chaque tableau de la plateforme PRAIS 4.
Les cartes par défaut sont disponibles dans la plateforme PRAIS 4 comme suit :
Population totale exposée à la sécheresse en 2000-2003
Population totale exposée à la sécheresse en 2004-2007
Population totale exposée à la sécheresse en 2008-2011
Population totale exposée à la sécheresse en 2012-2015
Population totale exposée à la sécheresse en 2016-2019
Population totale exposée à la sécheresse en 2020-2023
Ces cartes montrent la classe d’intensité de sécheresse la plus élevée à laquelle une population a été exposée au cours de chaque période de 4 ans, comme expliqué à l’étape 4.
Les Parties qui génèrent des cartes dans Trends.Earth à partir de données nationales ou alternatives représentant la population exposée à la sécheresse peuvent télécharger ces mêmes cartes, mentionnées ci-dessus, vers PRAIS 4 si elles disposent de données suffisantes.
Les Parties sont également invitées à fournir des explications sur la méthodologie, les sources des données et la fiabilité de celles-ci lorsque les estimations sont calculées à partir de données nationales, en utilisant le champ « Observations générales ». Il serait également utile de signaler les cas particuliers et les problèmes rencontrés, en décrivant les situations dans lesquelles les valeurs pourraient être moins fiables et en justifiant le choix d’une méthodologie différente.
Une fois le formulaire rempli et vérifié par les Parties, il doit être marqué comme « En cours d’examen » puis enregistré. Une fois que la CNULCD a achevé son examen et que les Parties ont donné suite à toutes les observations formulées, le formulaire peut être marqué comme « Finalisé » puis enregistré.
3.2.4. Dépendances
Les données relatives à l’exposition à la sécheresse s’appuient sur les résultats spatiaux du module OS 3-1 et sur les estimations démographiques figurant dans le tableau CP-1.T2.
3.2.5. Difficultés
Disponibilité et qualité des données
Parmi les ensembles de données démographiques mondiaux accessibles au public, l’ensemble de données WorldPop est utilisé par défaut par la CNULCD pour le calcul de l’indicateur OS2-3 et est mis à la disposition des Parties sur la plateforme Trends.Earth. Il convient de noter que, bien que la School of Geography and Environmental Science de l’université de Southampton (Royaume-Uni) ait récemment publié un nouvel ensemble de données démographiques mondiales pour la période 2015-2030, celui-ci a été publié après le lancement du processus de compte rendu 2026 et n’a donc pas pu être intégré aux ensembles de données par défaut fournis aux Parties. Les Parties peuvent néanmoins télécharger les nouveaux ensembles de données ventilées par sexe directement à partir de ce lien : https://hub.worldpop.org/project/categories?id=8. Une application GEE tierce permet une exploration approfondie de cet ensemble de données. Si ces ensembles de données sont jugés appropriés, les Parties peuvent les télécharger sur Trends.Earth, calculer les données des indicateurs correspondants et importer les résultats dans PRAIS 4 afin de remplacer les données par défaut.
Les Parties doivent également noter que l’ensemble de données WorldPop 2000-2020, utilisé comme source de données par défaut pour les comptes rendus de 2026, n’a pas été mis à jour et que, par conséquent, les trois dernières années (2021, 2022 et 2023) reprennent les valeurs de 2020.
La qualité des données mondiales et la résolution spatiale pourraient ne pas être suffisamment précises pour les estimations nationales de la population. L’intégration des données mondiales et nationales pourrait améliorer la qualité et la précision des résultats, mais nécessitera que les Parties disposent de capacités de traitement et de compétences techniques supplémentaires.
La méthodologie ne tient compte que de la densité et de la répartition de la population, et ne couvre pas l’exposition des écosystèmes à la sécheresse. Une mesure de l’exposition à la sécheresse plus complète pourrait prendre en compte d’autres entités physiques à risque, telles que les rendements agricoles, les têtes de bétail, l’eau et certains types de végétation. Par ailleurs, le fait d’être exposé à la sécheresse n’est pas synonyme de vulnérabilité à la sécheresse.
3.2.6. Résumé (principales étapes)
Les principales étapes à suivre pour présenter des comptes rendus sur l’exposition de la population au risque de sécheresse sont les suivantes :
Sélectionner l’ensemble de données sur la population : les Parties peuvent décider d’utiliser les données par défaut ou d’autres sources mondiales ou nationales, à condition qu’elles soient conformes aux spécifications des données énumérées dans le tableau 20. Si les Parties décident d’utiliser d’autres sources de données, elles doivent suivre les étapes 2 à 4 ci-dessous.
Superposer les données démographiques sur les résultats spatiaux de l’indicateur OS 3-1 : l’indicateur OS 3-2 est calculé en superposant les données démographiques annuelles sur les données annuelles d’intensité des risques issues de l’analyse de l’indicateur OS 3-1.
Calculer la proportion totale exposée de la population ainsi que la proportion de la population dans chaque classe d’intensité de la sécheresse : la population totale exposée à la sécheresse, en nombre de personnes, est auto-calculée dans PRAIS 4 sur la base des données démographiques rapportées dans CP-1.T2. La proportion d’hommes et de femmes dans chaque classe d’intensité de la sécheresse doit également être indiquée.
Créer des cartes d’exposition à la sécheresse par périodes de quatre ans : le résumé spatial maillé pour chaque période de quatre ans fournit des informations sur le nombre de personnes exposées à la classe d’intensité de sécheresse la plus élevée sur chaque période de quatre ans, de 2000 (ou l’année la plus ancienne pour laquelle des données démographiques sont disponibles) à l’année de référence, à l’échelle de la cellule de la grille. Ces périodes de quatre ans doivent être cohérentes avec les résumés spatiaux maillés rapportés dans l’OS 3-1.
Vérifier les résultats : conscientes des limites des valeurs estimées de l’exposition à la sécheresse, les Parties peuvent vérifier l’exactitude et la fiabilité de cet indicateur dans leur pays avant de soumettre officiellement leurs estimations aux fins des comptes rendus au titre de la CNULCD.
Enregistrer le formulaire et le rendre disponible pour examen : une fois vérifiées par les Parties, les données et la note explicative doivent être marquées comme « En cours d’examen » et enregistrées, afin de les rendre disponibles pour examen par la CNULCD.
3.2.7. Ressources supplémentaires
Beta Test Our New Global Population Data – 2015 to 2030, WorldPop (https://www.worldpop.org/blog/beta-test-our-new-global-population-data-2015-to-2030/)
3.3 OS 3-3 – Évolution du degré de vulnérabilité à la sécheresse
3.3.1. Introduction
L’approche adoptée par la CNULCD pour évaluer la vulnérabilité à la sécheresse s’appuie sur un indice composite, l’indice de vulnérabilité à la sécheresse, qui intègre trois composantes représentant la vulnérabilité de la population d’un pays individuel à la sécheresse : i) sociale, ii) économique et iii) infrastructurelle. À l’heure actuelle, cet indice ne tient pas compte de la vulnérabilité écologique ou écosystémique.
On peut calculer l’indice de vulnérabilité à la sécheresse au moyen de trois processus différents, correspondant à trois niveaux croissants de complexité :
Évaluation de la vulnérabilité de niveau 1 : utilise au moins un facteur par composante de la vulnérabilité, représenté par des mesures à l’échelle du pays.
Évaluation de la vulnérabilité de niveau 2 : utilise plus d’un facteur par composante de la vulnérabilité, les facteurs étant représentés par des mesures à l’échelle du pays, en incluant des données ventilées par sexe (le cas échéant).
Évaluation de la vulnérabilité de niveau 3 : utilise plusieurs facteurs par composante de vulnérabilité, ces facteurs étant représentés par des indicateurs infranationaux (qui peuvent être maillés ou désagrégés par régions administratives), et inclut des données désagrégées par sexe (le cas échéant).
Les Parties peuvent choisir l’approche la mieux adaptée à leurs capacités actuelles en matière de collecte et de traitement de données, en fonction de la disponibilité des données.
La CNULCD fournit aux Parties des données par défaut tirées de l’ensemble de données mondial sur l’indice de vulnérabilité à la sécheresse du Centre commun de recherche de la Commission européenne pour faciliter la présentation des comptes rendus. Ces données sont tirées d’ensembles de données disponibles au niveau mondial et doivent être utilisées en l’absence de données plus précises au niveau national.
3.3.2. Conditions préalables à la présentation de comptes rendus
Une lecture approfondie du chapitre 3 du Good Practice Guidance for National Reporting on UNCCD Strategic Objective 3 : To mitigate, adapt to, and manage the effects of drought in order to enhance resilience of vulnerable populations and ecosystems, qui détaille la méthodologie employée pour estimer l’exposition à la sécheresse ;
Des données conformes aux spécifications énumérées dans le tableau 21 ;
Un groupe d’experts nationaux officiellement désignés par les autorités nationales pour vérifier la cohérence des résultats du processus de déclaration par rapport à la situation sur le terrain, ou pour élaborer et mettre en œuvre une méthodologie sur mesure permettant d’estimer l’indicateur OS 3-3 lorsque les données nationales sont préférables aux données par défaut. L’institution clé dans ce cas est l’office national de statistique du pays concerné, mais les universités et les centres de recherche peuvent également apporter une contribution précieuse.
3.3.3. Cycle de présentation des comptes rendus et procédure étape par étape
La procédure de compte rendu étape par étape est décrite ci-après. Si les Parties décident d’utiliser les données par défaut, les étapes 2 à 5 ne sont pas nécessaires.
Étape 1 : Sélectionner le niveau d’évaluation de la vulnérabilité en fonction de la disponibilité des données
Les facteurs de vulnérabilité (énumérés dans la figure 7) recommandés par la CNULCD pour calculer l’indice de vulnérabilité à la sécheresse (DVI) donnent un aperçu de la vulnérabilité socio-économique d’une Partie face à la sécheresse. Les trois facteurs essentiels recommandés pour l’évaluation de la vulnérabilité de niveau 1 sont les suivants :
Taux d’alphabétisation (% des personnes âgées de 15 ans et plus) ;
Part de la population vivant sous le seuil de pauvreté
Part de la population utilisant des services d’approvisionnement en eau potable gérés en toute sécurité
Ces indicateurs ont été sélectionnés car ils ont été identifiés par des experts comme essentiels à la compréhension de la vulnérabilité et parce qu’ils sont utilisés dans le cadre d’autres obligations de compte rendu, telles que l’OS 2 et les Objectifs de développement durable.
_Figure 7. Composantes sociales, économiques et infrastructurelles, ainsi que les facteurs associés, recommandés pour le calcul de l’indice de vulnérabilité à la sécheresse. Les facteurs clés sont mis en évidence dans les encadrés vert foncé.
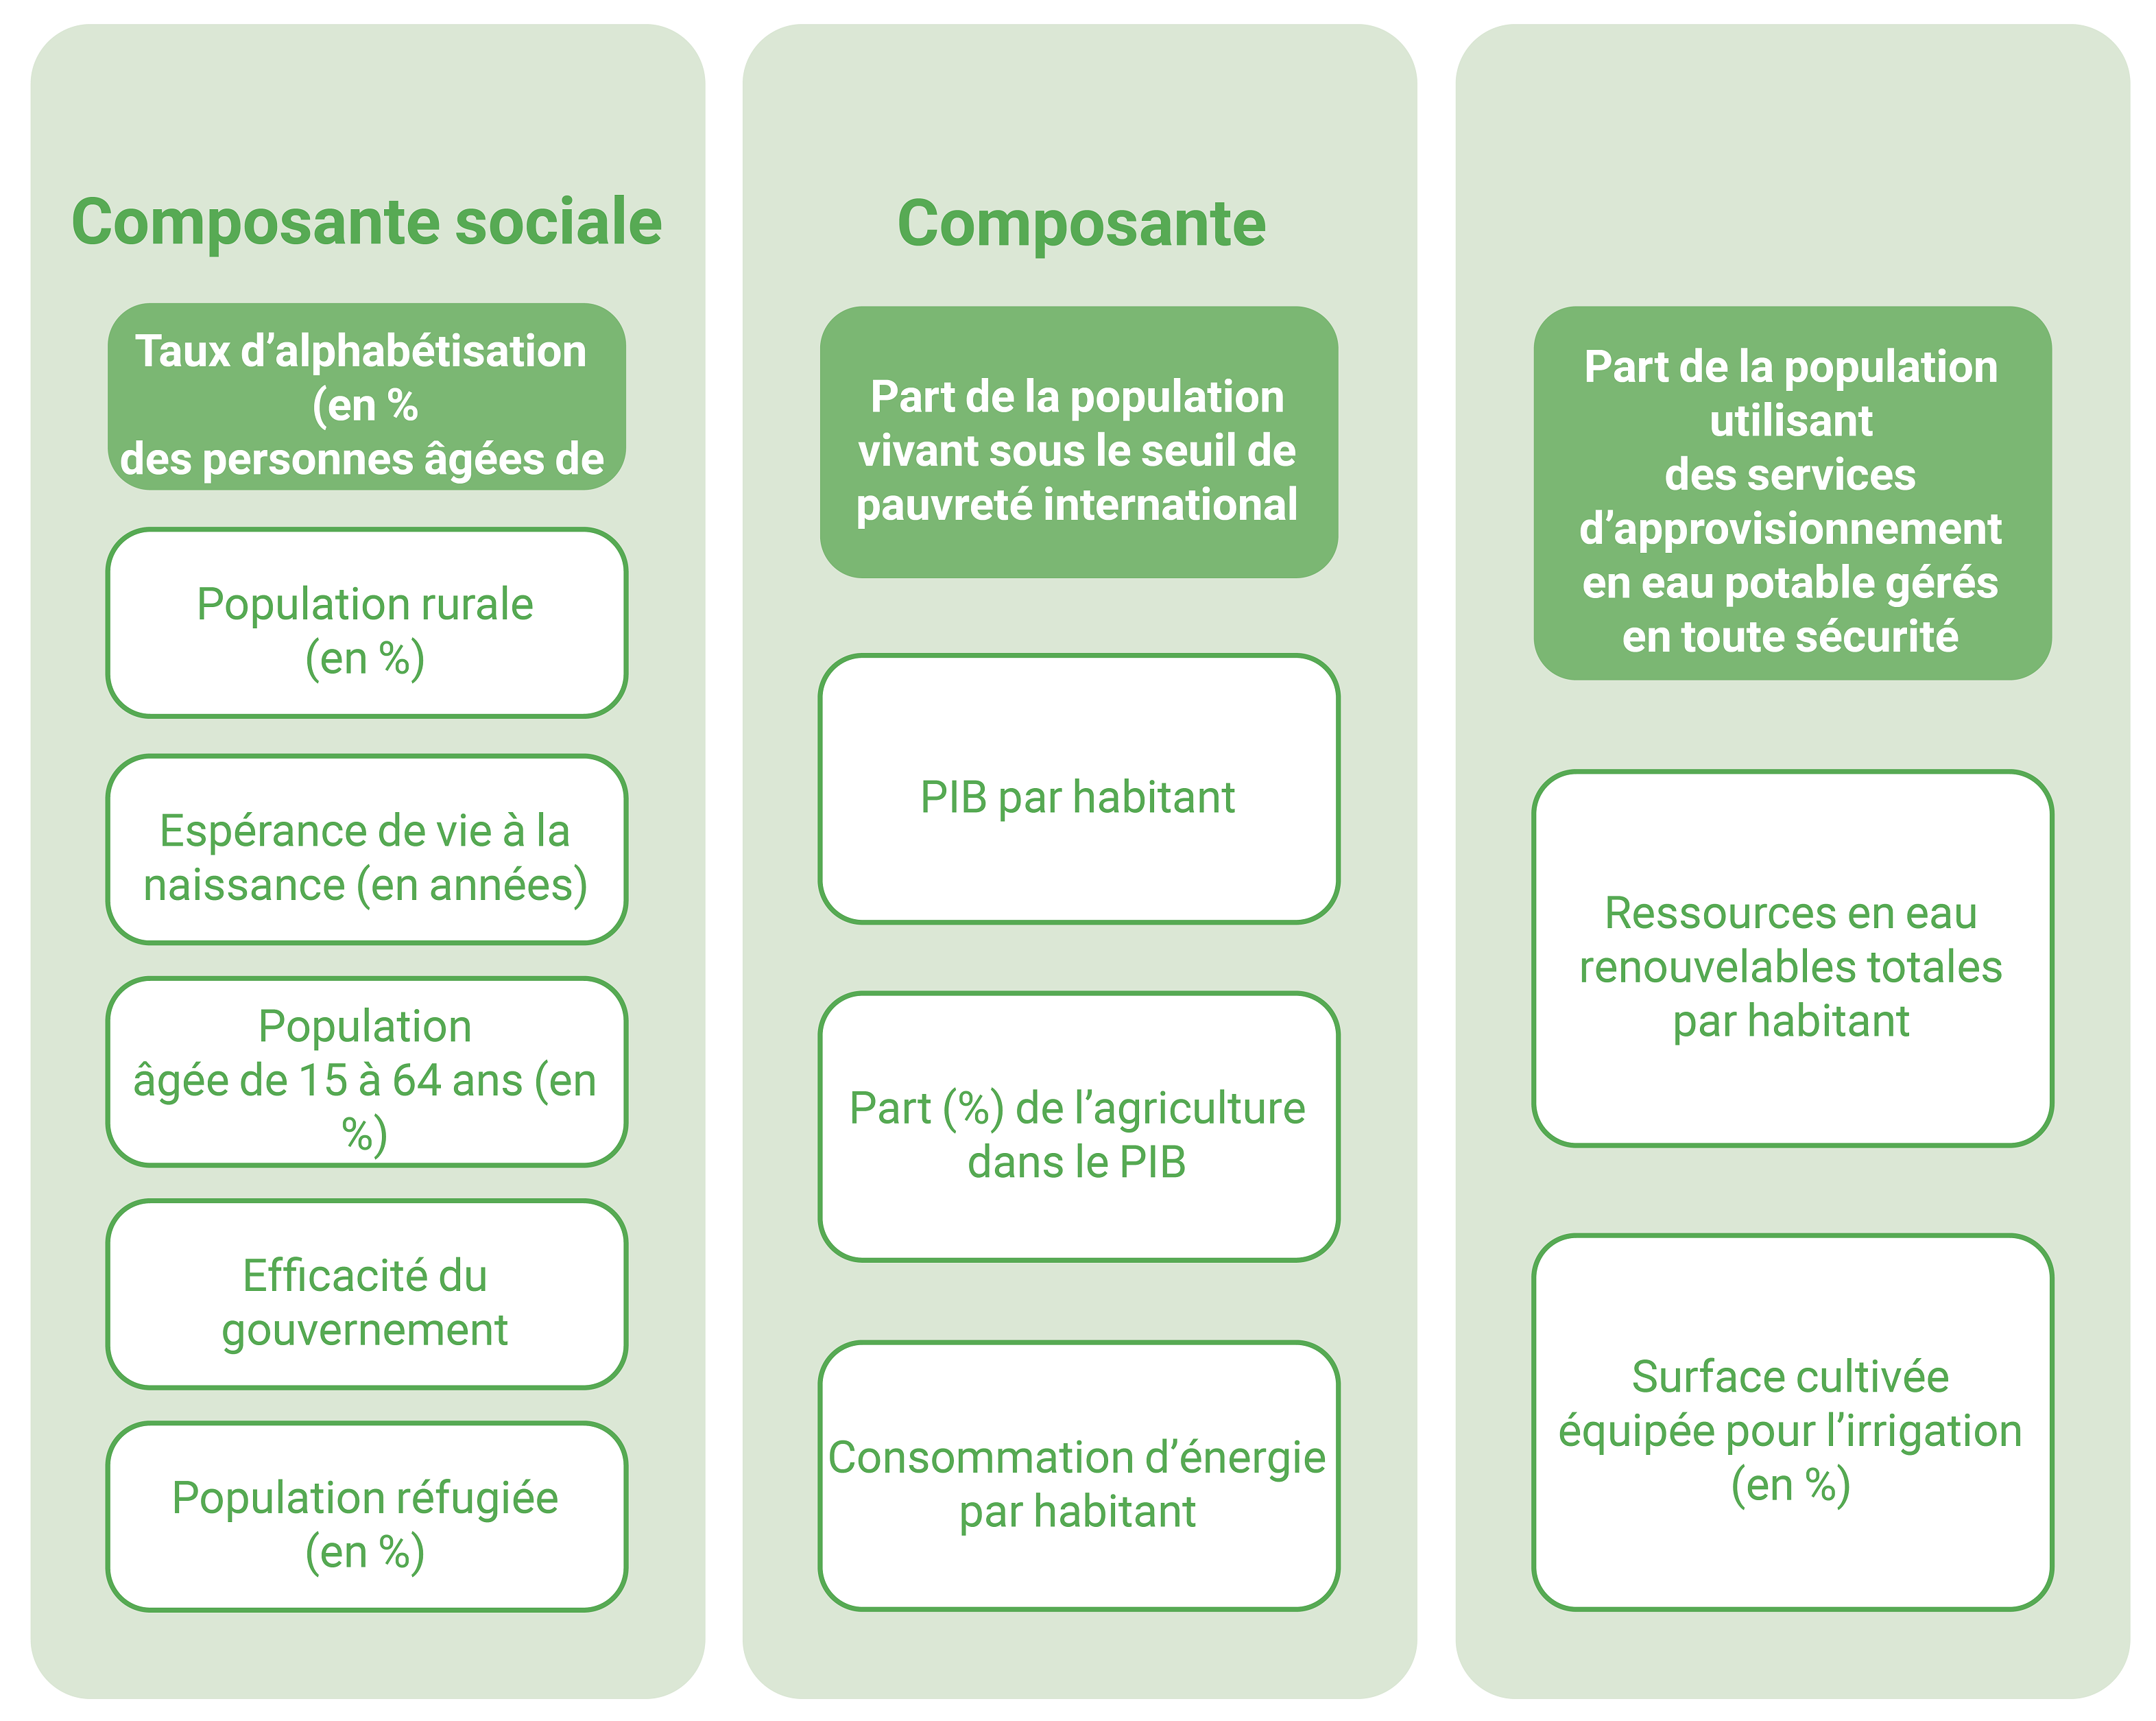
La CNULCD fournit des données par défaut issues de l’ensemble de données mondial sur l’indice de vulnérabilité au désert (DVI) du CCR. La méthode utilisée pour calculer le DVI par défaut est similaire à celle présentée dans le présent manuel et dans le document intitulé [« Guide des bonnes pratiques pour l’établissement des comptes rendus nationaux sur l’objectif stratégique n° 3 de la CNULCD »](https://www.unccd.int/sites/default/files/documents/ 2021-09/UNCCD_GPG_Strategic-Objective-3_2021.pdf), mais présente quelques différences notables en termes de méthode de normalisation (voir l’étape 2) et de nombre de facteurs pris en compte. Deux facteurs supplémentaires sont utilisés dans l’indice DVI par défaut : « Prévention et préparation aux catastrophes (USD/an/capital) » et « Carte mondiale de l’accessibilité : temps de trajet vers les grandes villes ». Une seule valeur par défaut de l’indice DVI est fournie ; elle correspond à la médiane de l’indice DVI à l’échelle nationale pour la période 2000-2018. Par conséquent, cette valeur par défaut est utilisée pour remplir la colonne correspondant à l’année 2018 dans le tableau OS3-3.T1.
Les États Parties qui ne disposent pas des données nécessaires au calcul de la valeur ajoutée (VA) minimale de niveau 1 peuvent établir leur rapport en utilisant les données par défaut de l’indice de développement (DVI). Il est toutefois recommandé de s’efforcer, au fil des cycles de compte rendu successifs, de passer à des niveaux supérieurs de VA afin d’accroître la sensibilité du DVI et d’améliorer la granularité de l’évaluation. L’arbre de décision de la figure 8 aide les États Parties à choisir le niveau de VA en fonction de la disponibilité des données.
Les produits de données nationaux/régionaux utilisés pour calculer l’indice DVI doivent être conformes aux spécifications énumérées dans le tableau 21.
Figure 8. Arbre de décision destiné à aider les Parties à choisir le niveau d’évaluation de la vulnérabilité le plus approprié pour la communication des données relatives à l’indicateur OS 3-3, en fonction de la disponibilité des données
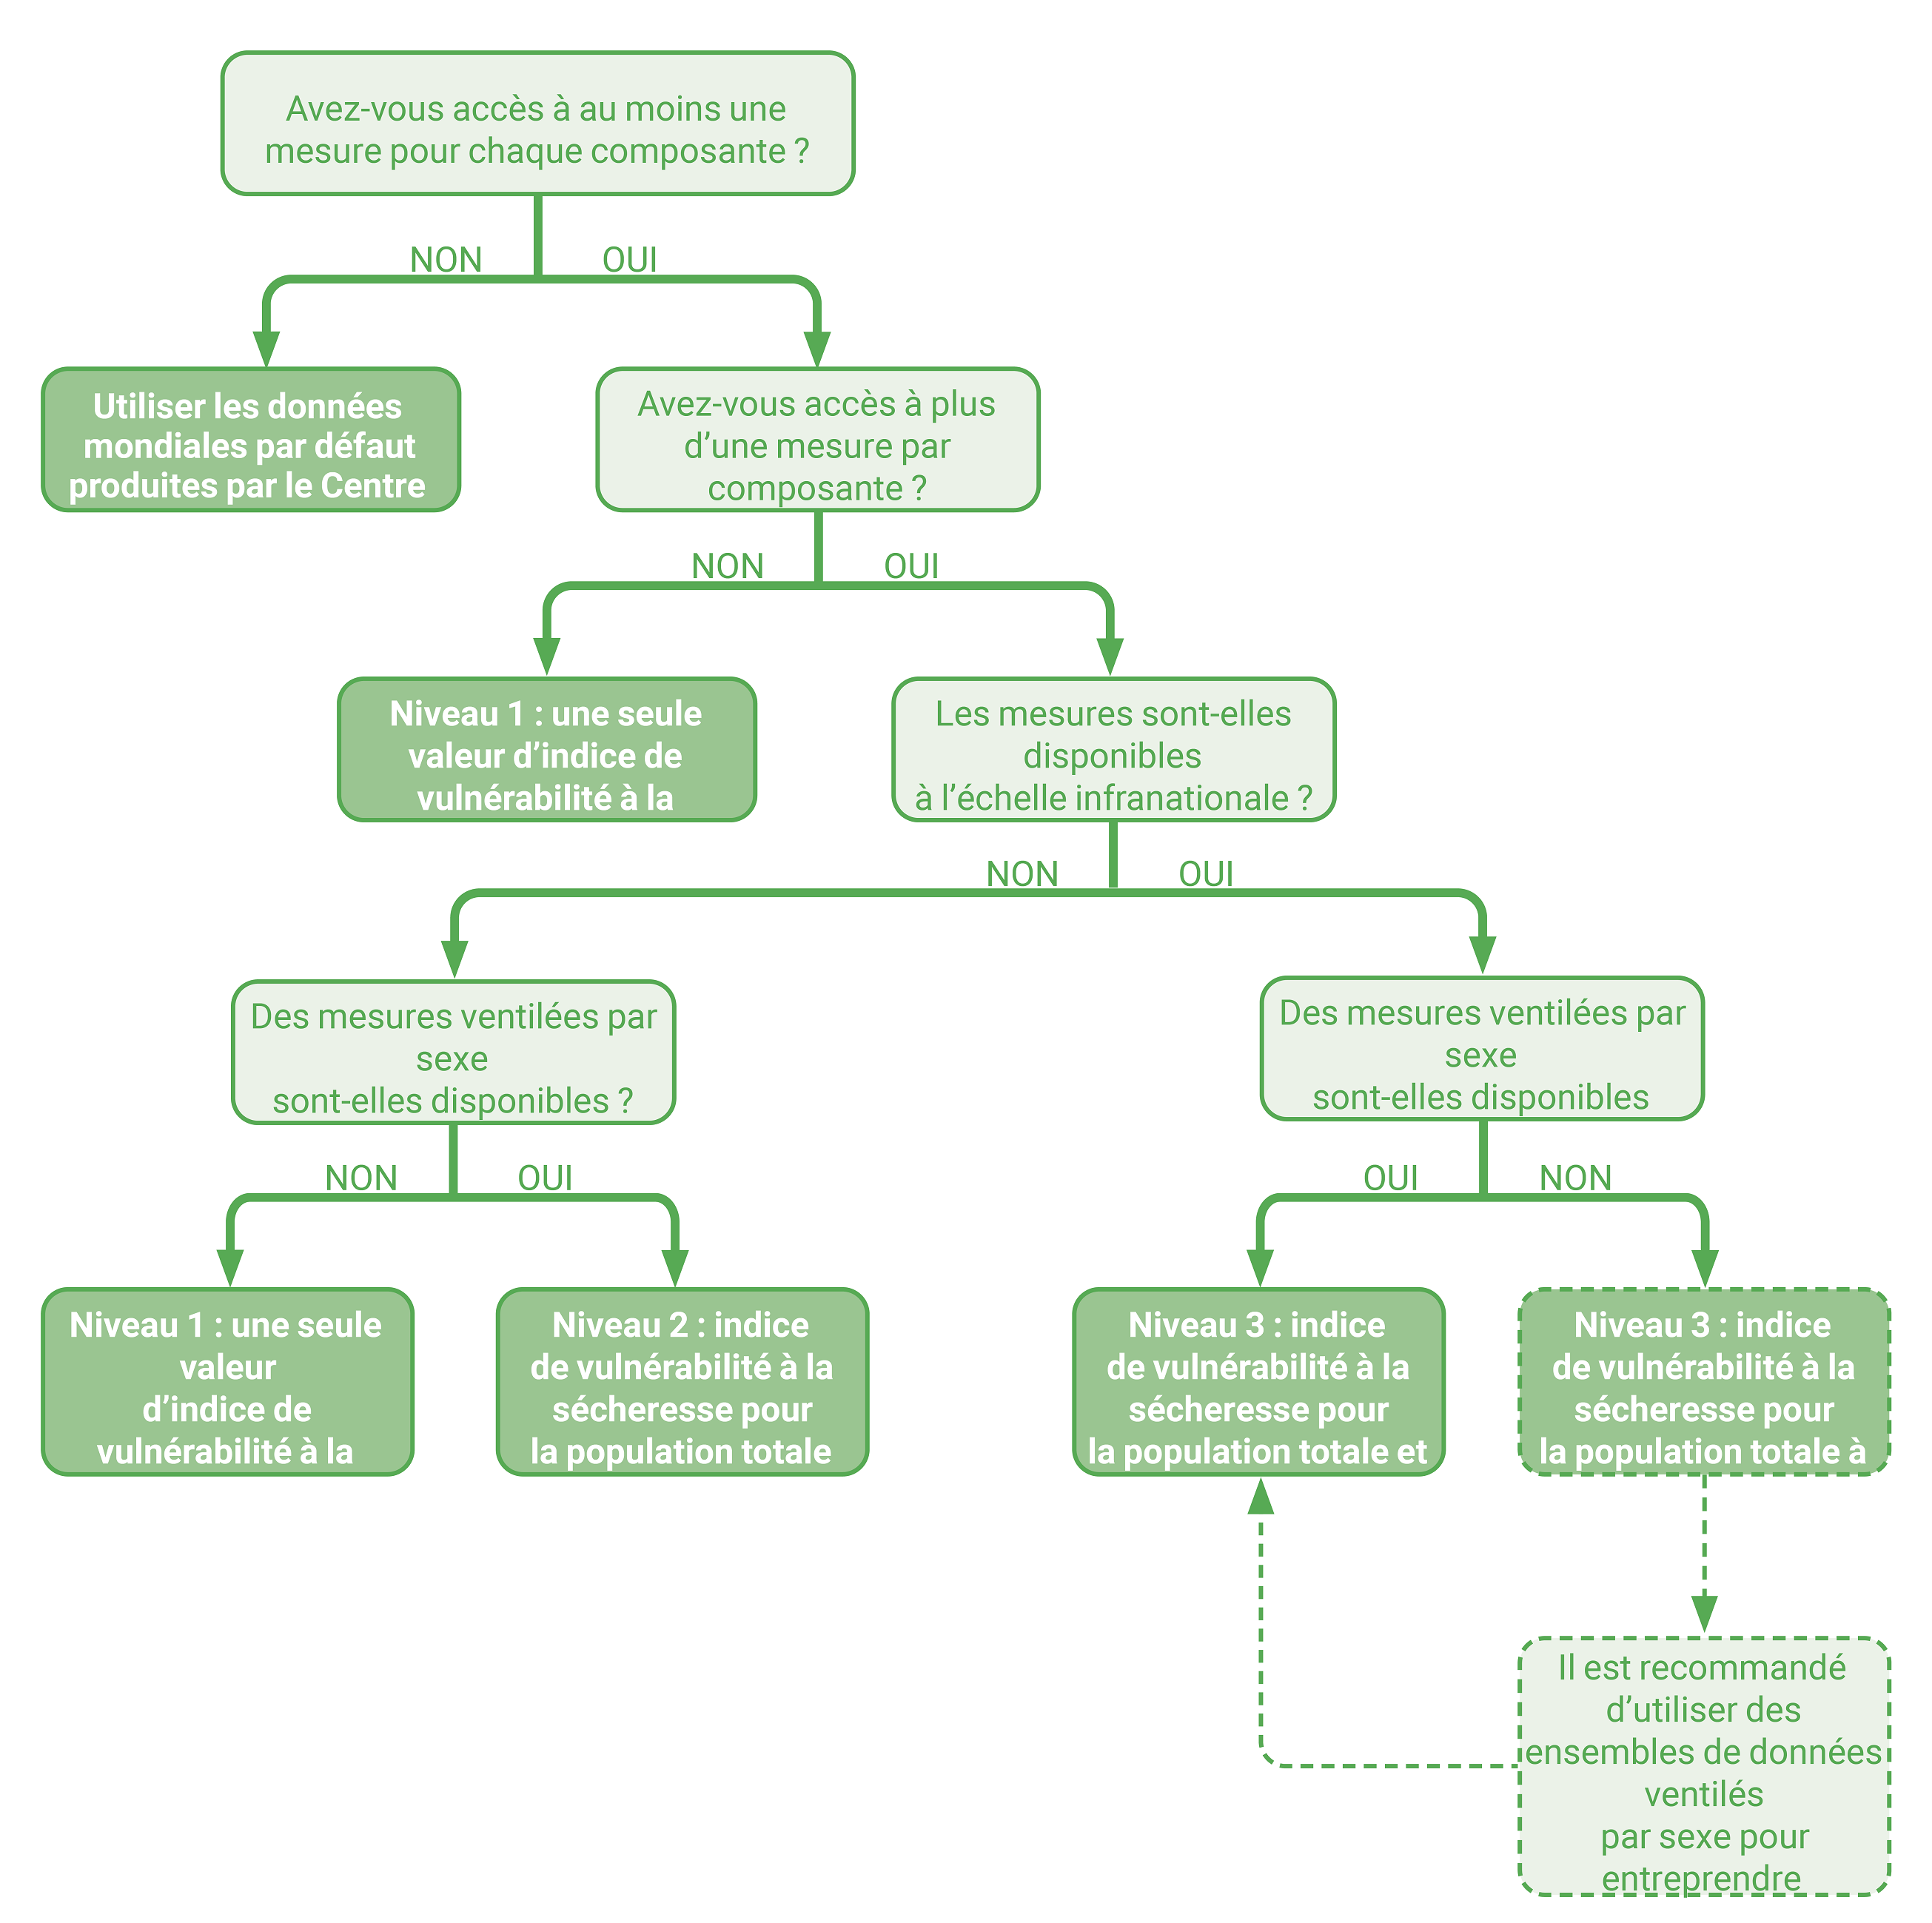
DVI : Drought Vulnerability Index
VA : Vulnerability Assessment
Élément |
Spécifications |
|
|---|---|---|
Données par défaut (ensemble de données sur l’indice de vulnérabilité à la sécheresse produit par le Centre commun de recherche) |
Données nationales |
|
Données entrantes Données nécessaires pour générer l’indicateur OS 3-3, comme décrit dans les étapes 2 à 4 |
Les données utilisées pour calculer l’indice de vulnérabilité à la sécheresse (DVI) par défaut proviennent de diverses sources, telles que la Banque mondiale, l’Organisation de coopération et de développement économiques, l’Organisation des Nations unies pour l’alimentation et l’agriculture et le Centre commun de recherche de la Commission européenne. |
Les ensembles de données librement accessibles permettant de calculer les facteurs nécessaires à l’établissement de l’indice DVI sont répertoriés dans le tableau 14 du document « Guide des bonnes pratiques pour l’établissement des comptes rendus nationaux sur l’objectif stratégique n° 3 de la CNULCD ». Sinon, si elles sont disponibles, des séries de données nationales présentant une meilleure résolution spatiale et moins de lacunes pour la période 2000-2023. |
Données sortantes Indicateur DVI résultant de l’analyse décrite aux étapes 2 à 4 |
DVI 2018 |
DVI annuelle ou quasi annuelle pour la période 2000-2023. |
Classification |
Échelle continue et fractionnaire de 0 à 1, mais classification basée sur des quantiles pour regrouper les classes de vulnérabilité. |
Échelle continue de 0 à 1. |
Résolution spatiale |
Niveau national |
Niveaux national et/ou infranational |
Qualité |
Précisé dans les métadonnées de l’ensemble de données. |
À indiquer dans les métadonnées de l’ensemble de données. |
Métadonnées |
Des métadonnées sont fournies avec les données par défaut. |
Les métadonnées minimales exigées pour chaque champ obligatoire sont énumérées à l’annexe II. |
Étape 2 : normaliser les facteurs
À tous les niveaux de l’évaluation de la vulnérabilité (VA), les facteurs doivent être normalisés avant de pouvoir être comparés et agrégés, car les facteurs de vulnérabilité utilisés sont tous mesurés selon des unités différentes.
Le Guide des bonnes pratiques pour l’établissement des comptes rendus nationaux sur l’objectif stratégique n° 3 de la CNULCD recommande de normaliser les facteurs en utilisant les valeurs maximales et minimales enregistrées au sein du pays, sur la base de l’ensemble des données historiques jusqu’à l’année de référence incluse (2023). Cela permet d’obtenir la fourchette la plus large possible, garantissant ainsi que les valeurs maximales et minimales sont représentatives du pays.
Lorsqu’il existe une corrélation ou une relation positive entre la vulnérabilité et le facteur [3]] (c’est-à-dire que si la valeur du facteur augmente, la vulnérabilité augmente également), les données doivent être normalisées à l’aide de l’équation ci-dessous :
\(Factor = \frac{X_{i} - X_{min}}{X_{max} - X_{min}}\)
Où :
Xi est la valeur du facteur considéré pendant l’année « i » ;
Xmin est la valeur minimale du facteur considéré observée sur la totalité de la série chronologique ;
Xmax est la valeur maximale du facteur considéré observée sur la totalité de la série chronologique.
En cas de corrélation/relation négative entre la vulnérabilité et le facteur, l’équation est la suivante :
\(Factor = 1 - \frac{X_{i} - X_{min}}{X_{max} - X_{min}}\)
Après la normalisation, tous les facteurs affichent une valeur située entre zéro et un, relative aux valeurs maximale et minimale historiques du pays en question.
La normalisation des données ventilées par sexe pour les VA de niveau 1 et 2 utilise les mêmes formules que celles décrites ci-dessus, appliquées une fois pour chaque donnée ventilée par sexe.
Pour les données au niveau infranational (VA de niveau 3), le calcul doit être appliqué à l’ensemble des données issues de toutes les unités spatiales (par exemple, les unités administratives) combinées, et la fourchette des facteurs doit refléter les valeurs minimales et maximales de l’ensemble du pays.
Pour l’indicateur DVI par défaut, chaque facteur a été normalisé à l’aide des valeurs maximales et minimales mondiales, plutôt qu’à partir des fourchettes historiques propres à chaque pays. Cette normalisation à l’échelle mondiale signifie que l’évaluation de la vulnérabilité qui en résulte est moins sensible à la situation locale ou nationale que lorsque les fourchettes nationales sont utilisées.
Étape 3 : Déterminer les composantes de l’indice de vulnérabilité à la sécheresse
Cette étape vise à obtenir des valeurs agrégées pour chacune des trois composantes de la DVI Pour les Parties qui n’utilisent qu’un seul facteur par composante de vulnérabilité, les valeurs du facteur normalisé à l’étape 2 sont également représentatives de la composante correspondante. En revanche, l’utilisation de plus d’un facteur par composante de vulnérabilité nécessite le calcul de la moyenne arithmétique des facteurs normalisés pour obtenir la valeur agrégée de chaque composante.
Cette étape aboutit à une valeur unique pour chaque composante et chaque unité géographique du pays. Si l’on utilise des données ventilées par sexe, des valeurs distinctes sont calculées pour les populations masculines et féminines pour chaque composante.
Les Parties peuvent attribuer des coefficients de pondération aux facteurs de vulnérabilité si leur importance relative et leur pertinence sont connues. Il est recommandé d’appliquer ces coefficients à chaque facteur de vulnérabilité pris individuellement, et non aux trois composantes.
Étape 4 : calculer l’indice de vulnérabilité à la sécheresse
Note
Domaines connexes sur la plateforme du système PRAIS 4 : tableau OS3-3.T1
À tous les niveaux de la VA, les trois composantes (Csocial, Ceconomic et Cinfrastructural) obtenues lors des étapes précédentes sont utilisées pour calculer l’indice DVI en déterminant leur moyenne arithmétique.
\(DVI = \frac{C_{\text{social}} + C_{\text{economic}} + C_{\text{infrastructural}}}{3}\)
L’indice de vulnérabilité à la sécheresse va de 0 à 1, 1 représentant la plus grande vulnérabilité.
Une VA de niveau 1 se traduirait par un IVC au niveau national pour chaque année pour laquelle des données sont disponibles (idéalement de 2000 à 2023). Pour les AV de niveaux 2 et 3, lorsque des facteurs ventilés par sexe sont utilisés, il est recommandé de calculer également des DVI spécifiques au sexe, en plus de la DVI au niveau national. Par conséquent, une Partie déclarera trois valeurs de la DVI pour chaque année disponible, c’est-à-dire pour la population totale, la population féminine et la population masculine. Pour les composantes infranationales ou maillées relevant de la VA de niveau 3, le DVI doit être calculé pour la plus petite unité spatiale, séparément pour les hommes, les femmes et les populations totales. Les valeurs annuelles du DVI pour les hommes, les femmes et la population totale doivent être utilisées pour compléter le tableau OS3-3.T1.
Étape 5 : Déclarer les facteurs utilisés pour calculer le DVI
Lorsque des données nationales sont utilisées pour remplir le tableau OS3-3.T1, les Parties doivent également indiquer les facteurs pris en compte dans le calcul. Une fois les données saisies dans le tableau OS3-3.T1, une série de tableaux supplémentaires, regroupés sous la rubrique « Méthode », sera mise à disposition pour être complétée. Pour chacune des composantes sociales, économiques et structurelles, les Parties doivent identifier les facteurs utilisés dans le calcul du DVI. En outre, les Parties doivent indiquer, pour chaque facteur utilisé, si des données ventilées par sexe étaient disponibles et si les calculs ont été effectués au niveau infranational.
Une fois les tableaux complétés, PRAIS déterminera et affichera automatiquement le niveau utilisé dans l’évaluation.
Les Parties doivent également indiquer l’évolution de l’indice DVI au fil du temps, en sélectionnant l’une des options du tableau OS3-3.T2. Des informations complémentaires peuvent être fournies dans le champ « Commentaires » correspondant.
Étape 6 : Vérifier les résultats
La méthode DVI n’a pas encore été validée à l’échelle locale ou nationale et, à ce titre, elle pourrait ne pas permettre de caractériser avec précision la vulnérabilité à ces échelles, que ce soit en termes de facteurs les plus pertinents pour chaque pays ou de système de pondération des facteurs le plus efficace. Par conséquent, les Parties peuvent vérifier la pertinence des facteurs par défaut et en ajouter d’autres, le cas échéant. Tout système de pondération utilisé par les Parties devrait également faire l’objet d’une évaluation approfondie s’il est utilisé pour améliorer les résultats aux niveaux national et infranational.
En outre, les populations les plus vulnérables et les groupes sous-représentés doivent participer à la détermination des facteurs qui seront utilisés pour calculer les composantes, afin d’élaborer un indice spécifique au pays et plus efficace.
Étape 7 : Enregistrer le formulaire et le mettre à disposition pour examen
Les informations sur la méthode utilisée (niveau sélectionné et facteurs par composant) doivent être rapportées en utilisant le champ de commentaires dédié associé au tableau OS3-3.T1 dans la plateforme PRAIS 4. Les changements observés et leur interprétation peuvent également être décrits dans ce champ.
Les cartes générées dans Trends.Earth à l’aide de données nationales dans le cadre de la VA de niveau 3 et représentant la vulnérabilité à la sécheresse au cours de la période analysée peuvent être téléchargées sur la plateforme PRAIS 4. Plus précisément, il est recommandé de télécharger les cartes suivantes :
Vulnérabilité à la sécheresse pour l’année 2000 ou l’année disponible la plus proche
Vulnérabilité à la sécheresse pour l’année 2023 ou l’année disponible la plus proche
Les informations relatives aux sources des données, à leur exactitude et à tout système de pondération appliqué aux facteurs de vulnérabilité peuvent être fournies dans le champ « Commentaires généraux ». Il serait également utile de signaler les cas particuliers et les problèmes rencontrés, en décrivant les situations dans lesquelles les valeurs pourraient être moins fiables et en justifiant l’inclusion de différents facteurs.
Une fois le formulaire rempli et vérifié par les Parties, il doit être marqué comme « En cours d’examen » puis enregistré. Une fois que la CNULCD a achevé son examen et que les Parties ont donné suite à toutes les observations formulées, le formulaire peut être marqué comme « Finalisé » puis enregistré.
3.3.4. Dépendances
Les OS 2-1 et OS 2-2 peuvent être utilisés pour le calcul de l’OS 3-3. Ceci est expliqué dans le Guide des bonnes pratiques pour les comptes rendus nationaux sur l’objectif stratégique 3 de la CNULCD. Chapitre 3. Indicateur de niveau 3.
3.3.5. Difficultés
Disponibilité et qualité des données
L’ensemble de données DVI mondial du CCR n’est disponible que pour l’année 2018.
La disponibilité des données relatives aux facteurs pris en compte varie considérablement d’un pays à l’autre, et il se peut que l’ensemble complet des données recommandées ne soit pas accessible partout.
Approche méthodologique
La fiabilité de la méthode DVI aux niveaux national et infranational doit encore être vérifiée par des experts nationaux.
En raison des méthodes employées pour normaliser les facteurs (à savoir utiliser les données historiques nationales), les valeurs de l’indice de vulnérabilité à la sécheresse ne doivent pas être comparées entre les pays.
En supposant qu’une méthodologie cohérente ait été utilisée au fil du temps, les variations de l’indice DVI peuvent refléter l’efficacité des politiques d’atténuation et d’adaptation à la sécheresse, mais elles peuvent également révéler les impacts de changements sociaux et économiques sans rapport avec les mesures de gestion de la sécheresse.
3.3.6. Résumé (principales étapes)
Les mesures clés à prendre pour recenser les populations exposées au risque de sécheresse sont les suivantes :
Choisir le niveau d’évaluation de la vulnérabilité en fonction de la disponibilité des données : les Parties sont encouragées à opter pour l’un des trois niveaux d’évaluation de la vulnérabilité en fonction de la disponibilité des données. En l’absence de données permettant de calculer la VA minimale de niveau 1, les Parties peuvent utiliser les données par défaut. Les produits de données nationales/régionales utilisés pour calculer le DVI doivent être conformes aux spécifications énumérées dans le tableau 21. Si les Parties utilisent des produits de données nationaux/régionaux, elles doivent suivre les actions 2 à 4 ci-dessous :
Normaliser les facteurs : les facteurs correspondant à chaque composante de la vulnérabilité doivent être normalisés avant de pouvoir être comparés et agrégés, car les facteurs de vulnérabilité utilisés sont tous mesurés dans des unités différentes.
Calculer les composantes du DVI : les valeurs cumulées des trois composantes de l’indice de vulnérabilité à la sécheresse sont calculées sous la forme de la moyenne arithmétique des facteurs normalisés.
Calculer le DVI : les trois composantes – sociale, économique et infrastructurelle – obtenues lors des étapes précédentes sont utilisées pour calculer les valeurs annuelles du DVI en déterminant leur moyenne arithmétique.
Déclarer les facteurs utilisés pour calculer le DVI : Lorsque des données nationales sont utilisées pour compléter le tableau OS3-3.T1, les Parties doivent également indiquer les facteurs utilisés pour le calcul.
Vérifier les résultats : conscientes du fait que la méthode DVI n’a pas encore été validée à l’échelle locale ou nationale, les Parties devraient vérifier la pertinence des facteurs par défaut et en ajouter d’autres, le cas échéant, avant de soumettre officiellement leurs estimations dans le cadre des comptes rendus au titre de la CNULCD.
Enregistrer le formulaire et le rendre disponible pour examen : une fois vérifiées par les Parties, les données de la période évaluée et la note explicative doivent être marquées comme « En cours d’examen » et enregistrées, afin de les rendre disponibles pour examen par la CNULCD.